認知度が21%から24%に上がっても、調査の誤差が5パーセントポイントあれば、結論は出せないままです。SurveyMonkeyのブランド認知度ガイドでもこの点が示されています。リーチした人が増えたからといって、ブランドを覚えている人が増えたとは限りません。調査スコアが上がった場合でも、成果と呼ぶ前に不確実性の確認が必要です。
ブランド認知度を測定する実践的な方法は、非助成想起と助成認知を追跡し、指名検索の需要と組み合わせ、施策の効果を検証したいときにはランダム化したホールドアウトを使うことです。クリエイター、代理店、開発者、複数のSNSアカウントを運用する小規模チームにとって、これは「覚えられているブランド」と「ただ配信されただけのコンテンツ」を切り分ける方法になります。
目次
- ブランド認知度の指標と、それぞれが示すこと
- 想起を測る調査の進め方
- 調査とあわせて追跡したい行動シグナル
- キャンペーンが認知度を高めたことを証明する方法
- よくある間違いと対処法
- ベースラインを設定し、四半期ごとに追跡する
ブランド認知度の指標と、それぞれが示すこと
ブランド認知度の指標、計算式、データソース
| 指標 | 測定するもの | 計算方法 | データソース |
|---|---|---|---|
| 非助成認知 | ヒントなしで挙げられたブランド | ブランド名を挙げた回答者数 ÷ 有効回答者数 × 100 | 調査 |
| 助成認知 | ランダム表示のリストから認識されたブランド | ブランドを認識した回答者数 ÷ 有効回答者数 × 100 | 調査 |
| 認知転換率 | 認識がどの程度想起につながっているか | 非助成の割合 ÷ 助成の割合 × 100 | 調査結果 |
| 指名検索のインプレッション | 検索におけるブランド名の需要 | ブランド関連語を含むクエリのインプレッションを前年同期と比較 | Search Console |
| ブランドリフト | キャンペーンによって生じたと推定される変化 | 接触群の割合 − 対照群の割合 | ホールドアウト調査 |
| メンション数とシェア・オブ・ボイス | 競合と比べた話題量 | ブランドのメンション数を集計し、カテゴリ全体のメンション数で割ってシェアを算出 | ソーシャルリスニングツール |
活動量を解釈する前に「記憶」を算出する
分母の設定が重要です。有効回答者とは、定義したターゲット市場に当てはまる人のことで、アンケートを開いた全員ではありません。TEM Journalのブランド認知に関するレビューは、認識と想起を区別したうえで、認知度を「ブランド名を挙げた、または認識した回答者数を有効回答者数で割り、100を掛けた値」として算出することを裏づけています。
ブランドが最初に挙げられたかどうかを示すトップ・オブ・マインド認知は、別の診断指標として分けて管理します。非助成の回答のどこかにブランドが入っていても、最初に思い浮かぶ選択肢とは限らないためです。
認知転換率は、自発的な想起と、ヒントを示されたうえでの親しみを比較する指標です。SurveyMonkeyのブランド想起の例では、非助成認知24%を助成認知60%で割り、100を掛けると転換率は40%になります。これはあくまで診断用の比率であり、特定の回答者がファネルを進んだことの証明ではありません。
認識と想起の差が大きい場合は、露出によって名前に見覚えはできたものの、思い出しやすくはなっていないことを示唆します。必要なのは配信量を増やすことではなく、カテゴリとの結びつきを明確にすることです。
配信量はダッシュボードの別列で管理する
リーチ、インプレッション、フォロワー数は、認知度を合成したスコアの中に含めず、記憶の指標の隣に並べて表示します。Riff Analyticsのブランドリーチの測定方法に関するガイドは、露出面を理解するうえで参考になります。また、別途SNS KPIのフレームワークを用意しておくと、配信、エンゲージメント、ビジネス成果のラベルを一貫して管理できます。
低予算でのルール:まず同じ調査の中で非助成認知と助成認知を測り、次に指名検索のインプレッションを加えます。定義が変わり続ける凝ったダッシュボードより、小さくても繰り返せる仕組みのほうが役に立ちます。
想起を測る調査の進め方
きれいな調査ウェーブは、キャンペーンレポートではなく、固定された質問票から始まります。Sprigのブランドトラッキングガイドは、カテゴリ、対象者、質問文、競合セットを一定に保ちながら、非助成認知と助成認知をあわせて追跡することを推奨しています。
設計からレポートまで、プロセスは一貫した形で残しておくことが大切です。
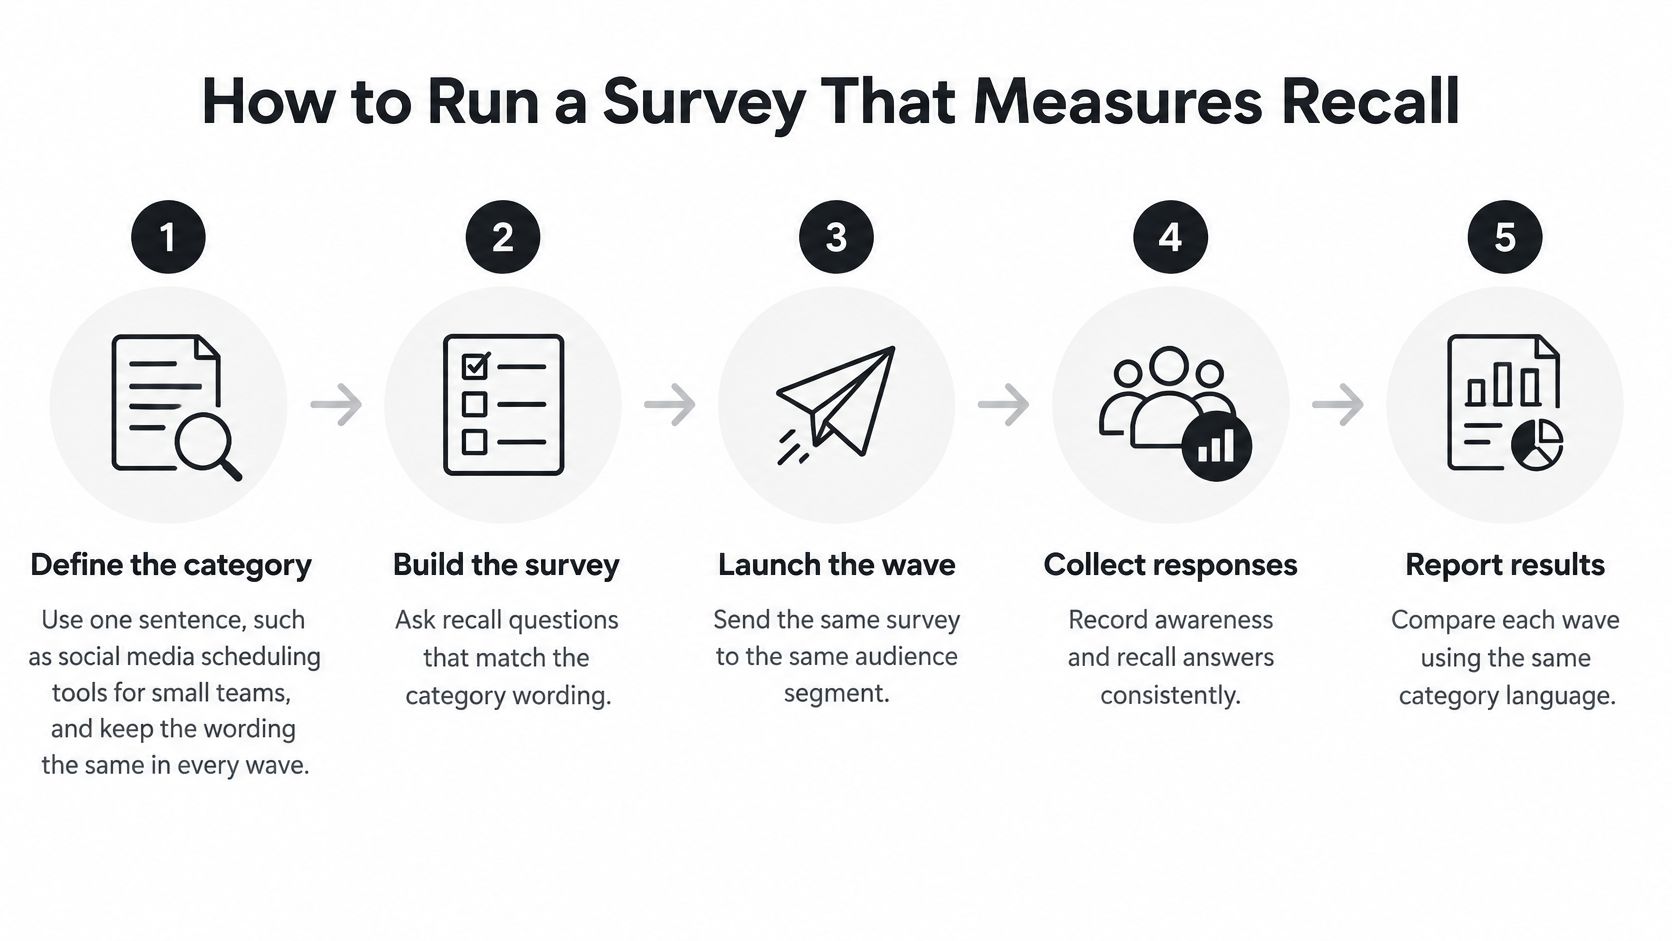
繰り返し実施できる調査ウェーブを設計する
カテゴリを定義する。「小規模チーム向けのSNS予約投稿ツール」のように一文で定めます。次のウェーブで「マーケティングソフトウェア」へ広げると、回答者が答える課題そのものが変わってしまいます。
競合リストを固定する。調査の実施前に関連性の高い代替ブランドを選び、表示順をランダム化します。回収の途中で話題の競合を加えると、質問票に一貫性がなくなります。
最初に非助成想起を尋ねる。名前やロゴを見せずに、そのカテゴリで思い浮かぶブランドを尋ねます。先にリストを見せると記憶の手がかりを与えてしまい、自発的な想起が汚染されます。
次に助成認知を測る。ランダム化したリストを提示し、どのブランドを知っているか、聞いたことがあるかを尋ねます。好意度の質問で代用しないでください。ブランドを好むことと、認識していることは別だからです。
対象者をスクリーニングする。そのカテゴリで購入する人や購買に影響を与える人を募集し、毎回同じ適格条件を使います。現在のフォロワーだけに調査すると、獲得可能な市場とは別の母集団になってしまいます。
フィールドワークの計画を立てる。有効回答の目標数、回収期間、募集方法を実施前に定めます。良さそうな結果が出たからといって、回収を早く打ち切るのは避けてください。
算出して確認する。想起、認識、認知転換率を、有効回答者を母数にして報告します。自由記述の回答は保存し、スペルミス、製品名、あいまいな回答のコーディングルールを決めておきます。
結果とあわせて調査手法も公開する。サンプルサイズ、ターゲット市場、実施期間、正確な質問文、不確実性、競合、前回のウェーブを記載します。こうした背景がないパーセンテージは検証が困難です。
Formbricksのブランド認知度調査の質問例は、質問票を作成する際の助けになります。ベースライン調査の前に文言を調整し、それ以降は不要な修正を控えましょう。
実施前に精度と理解度を確認する
有効回答者400人の単純無作為抽出を仮定すると、標準的な比率の計算では、50%付近で95%信頼水準の誤差は約4.9パーセントポイント、21%付近では約4ポイントになります。これらはあくまで計算例であり、オプトイン型パネルについて保証するものではありません。ウェイト付けや募集方法によって不確実性は変わります。
このサンプルサイズで21%から24%へ上がったと仮定しても、統計的に信頼できる上昇とは言えません。さらに、有意性を判断するには、1回のウェーブの誤差を変化量が上回るかどうかだけでなく、ウェーブ間の差の不確実性を確認する必要があります。
助成認知の質問のあとに、そのブランドが何を提供し、誰のためのものかを尋ねる自由回答を加えます。正しい連想、誤った連想、不明確な連想を別々にコーディングすれば、名前の認知がポジショニングの問題を覆い隠すことを防げます。
調査とあわせて追跡したい行動シグナル
行動シグナルは、ブランドをめぐる人々の行動を映し出します。記憶を直接調べる調査の代わりにはなりませんが、どの変化を掘り下げるべきかを見極める助けになります。
使いやすいダッシュボードでは、各シグナルの定義が常に見えるようにしておきます。
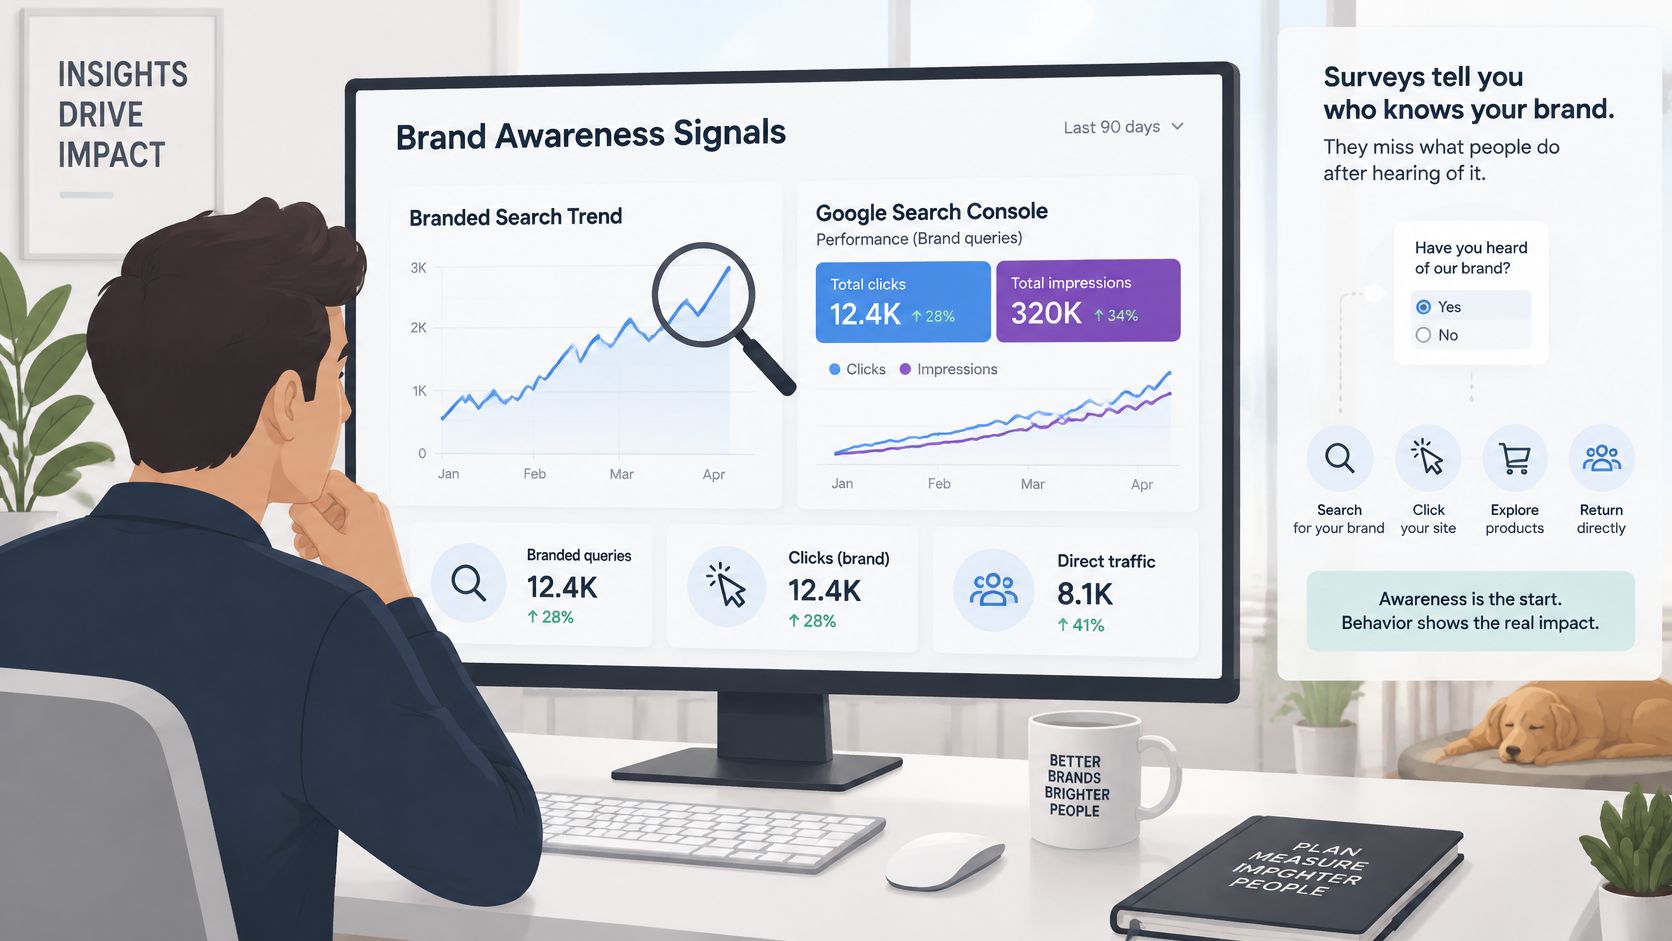
検索需要とサイト訪問を切り分ける
Google Search Consoleでは、検索パフォーマンスのレポートをブランド名、製品名、よくある誤字で絞り込みます。Search Engine Landの指名検索に関するガイドは、季節による歪みを減らすため、直近3か月を前年の同じ期間と比較することを推奨しています。
インプレッションは、指名検索の結果に表示された回数を記録します。一方、クリックは、順位、スニペット、競合する検索結果、訪問を必要としない回答にも左右されます。可能であれば、国、デバイス、クエリグループ別に結果を分けて確認してください。
行動シグナルが示すことと、確認方法
| シグナル | 示せること | 証明できないこと | 変化を成果として評価する前の確認事項 |
|---|---|---|---|
| 指名検索のインプレッション | Googleの検索結果における名前の需要 | 新規の人かどうか、キャンペーンが原因かどうか | 季節性が同等の期間で比較し、調査ウェーブと組み合わせる |
| ダイレクトトラフィック | 参照元のない訪問 | 新たな認知(リピート訪問、ブックマーク、URLの直接入力も含まれるため) | 単独では見ず、調査ウェーブと並べて推移を確認する |
| メンション数とシェア・オブ・ボイス | 競合と比べたブランドの話題量 | ユニークな到達数や、記憶に残った露出 | 毎月同じ範囲で集計し、ブランドのメンション数をカテゴリ全体のメンション数で割る |
| AIアシスタントでの言及率 | 固定したプロンプトに対してアシスタントがブランド名を挙げる頻度 | 人々の記憶や想起 | 毎回のウェーブで同じプロンプト、アシスタント、設定を使う |
提供される指標はネットワークごとに少しずつ異なり、FoPostのダッシュボードには各ネットワークが報告する内容が表示されます。あるネットワークのフォロワー数を別のネットワークのリーチと比べるべきではありません。一貫したSNSアナリティクスのワークフローを整えて、こうしたラベルの違いを保ちましょう。
認知度測定を別の形式で確認できる動画もあります。
AI経由の発見を「想起」とは呼ばずに検証する
購入検討者が尋ねそうな質問を20〜30問用意します。これは検証済みのサンプルサイズではなく、実務上のテスト設計として扱ってください。複数ネットワークへの予約投稿、エージェントによる投稿の制御、API経由の投稿、アナリティクスに関する質問を含めます。
HubSpotのAI可視性に関するガイドにならい、ブランドの登場、説明の正確さ、競合への置き換わり、引用元を記録します。言及率は、ブランドに言及した回答数を分析した回答数で割り、100を掛けて算出し、アシスタントのバージョン、場所、言語、日付もあわせて記録します。
アシスタントが誤ったユースケースを説明しているなら、ブランドが目立つ形で登場していても、可視性の成果とは言えません。
たとえば、ポッドキャストのキャンペーン後に指名検索のインプレッションが増えたとします。ポッドキャストの成果とする前に、次の想起ウェーブを確認してください。AIでの言及が増えた場合にも、同じ姿勢で臨みます。
キャンペーンが認知度を高めたことを証明する方法
施策前後の比較から、認知度が変化したことは確認できます。しかし、それだけではキャンペーンが変化の原因だったとは言えません。同じ期間に、競合の活動、報道、ほかのマーケティング施策があった可能性があるためです。
ランダム化ホールドアウト調査は、より強力な反事実(キャンペーンがなかった場合、同等の対象者に何が起きたか)を示します。
設計は、広告を配信する前から始まります。
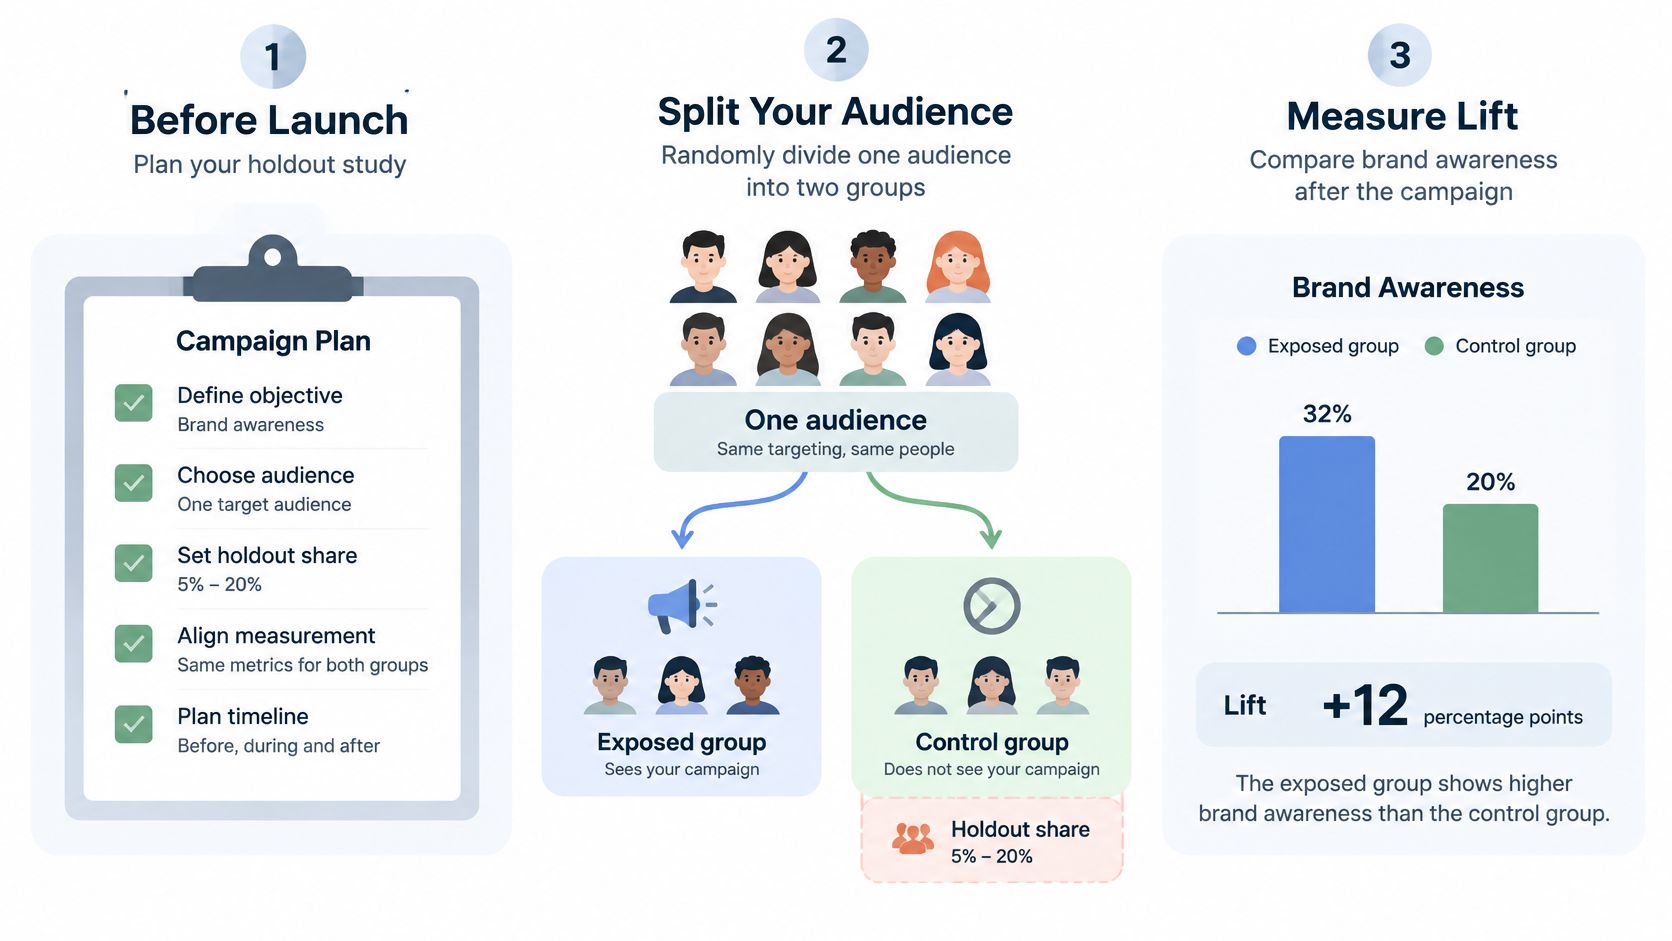
開始前に比較の条件を決める
- 対象者をランダムに振り分ける。キャンペーンを受け取れる接触群と、受け取らない対照群に割り当てます。Sprigの広告効果ガイドは、対照群の割り当てとして5%〜20%が一般的だとしつつ、必要なサンプルサイズは検出したい最小のリフトによって決まると述べています。
- ホールドアウトを固定する。配分は開始前に確定します。結果を見てからグループ間で人を入れ替えると、比較の信頼性が損なわれます。
- 測定方法を同一に保つ。両グループを同じ期間に調査し、非助成の質問をランダム化した助成リストの前に配置します。文言が異なると、露出の差に加えて測定上の差も生じてしまいます。
- 先に実現可能性を確認する。商業的に意味のある最小の効果を検出するために必要なサンプル数を見積もります。対照群が小さすぎると、本来は妥当なテストでも結論が出なくなる可能性があります。
キャンペーンの配信を止めるために代替の配信枠が必要な場合は、対照群に無関係なプレースホルダーを使います。クリエイティブそのものの記憶を確認するために広告想起の質問も加えますが、その回答をランダム化比較の代わりとして扱わないでください。
絶対リフトと相対リフトを算出する
仮の結果で考えてみましょう。
| 指標 | 計算例 |
|---|---|
| 接触群の助成認知 | 30% |
| 対照群の助成認知 | 24% |
| 絶対リフト | 30% − 24% = 6パーセントポイント |
| 相対リフト | 6 ÷ 24 × 100 = 25% |
これらは説明のための数値であり、実際のキャンペーン結果ではありません。パーセントポイントとパーセントのリフトは同じ意味ではありません。前者はスコア間の差を表し、後者はその差を対照群の結果に対する比率で表します。
信頼できるレポートには、取得していればベースライン、接触群と対照群の結果、絶対リフト、相対リフト、各グループのサンプルサイズ、実施期間、不確実性を含めます。結果の精度が低すぎる場合は、効果がなかった証拠ではなく、結論が出なかったものとして報告します。
キャンペーンの計画には、MyMentionsのSaaSブランド認知度ガイドが、検証する施策を整理する助けになります。戦略文書と、因果関係を判断するための証拠は別々に管理してください。
よくある間違いと対処法
最もよくあるレポート上の誤りは、大きなリーチの数字を認知度の結果として提示することです。Webianoのブランドリフトガイドは、露出の指標と、想起や認識の指標を区別し、キャンペーン結果とあわせて調査手法も報告することを推奨しています。
配信面での成功は称えるに値するかもしれません。ただし、正しいラベルを付ける必要があります。
認知度測定でよくある間違いと対処法
| 間違い | 誤解を招く理由 | 対処法 |
|---|---|---|
| リーチやインプレッションを認知度として報告する | リーチが示すのは露出であり、記憶ではない | リーチを非助成想起や助成認知と並べて報告する |
| わずかな変化を成果として報告する | 見かけ上の改善は標本のばらつきで説明できる場合がある | 差の不確実性を検定し、過去のウェーブと比較する |
| 助成の質問を先に尋ねる | 表示されたリストが回答者への手がかりになる | 毎回のウェーブで非助成の質問を先に尋ねる |
| 競合リストや質問文が変わる | 質問が異なると比較可能性が下がる | 両方を固定し、やむを得ず変更した場合は記録する |
| キャンペーン前のベースラインがない | 1回のウェーブだけでは変化を確認できない | 開始前に測定し、ホールドアウトを計画する |
| 認識を理解と同一視する | 見覚えがあっても、誤ったユースケースで覚えられていることがある | ブランドが何をしているのか、誰のためのものかを尋ねる |
結論は証拠の強さに合わせる
表にある対処法は、それぞれ異なる失敗のポイントに対応しています。リーチの水増しは解釈の問題、質問順は測定器具の問題、競合の入れ替えは比較可能性の問題です。これらを1つのダッシュボードスコアにまとめてしまうと、根底にある誤りが見つけにくくなります。
ベースラインがないことも、語れる内容を制限します。キャンペーン前の調査がなくても、ランダム化したキャンペーン比較ならリフトを推定できますが、キャンペーン後の単独のスコアからは、ブランドのこれまでの方向性を説明できません。
誤った連想には、レポート上で独立した項目を設けましょう。開発者向けの投稿プロダクトが、一般消費者向けの写真編集アプリとして認識されていたとしても、有益なカテゴリ認知を示すものではありません。プロモーションを強化する前に、メッセージングと参照元の文脈を点検する必要があります。
レポートの基準:結果は「観察された」「統計的に裏づけられた」「結論が出なかった」のいずれかとして表記します。有望な傾向を、実証された改善に格上げしないでください。
進捗を宣言する前に、差が想定される標本のばらつきより大きいか、募集方法や質問文の比較可能性が保たれているか、過去のウェーブや競合と比べても変化が続いているかを確認します。統計的に信頼できる上昇であっても、購入者が誤ったことを覚えているなら、戦略的には弱いままです。
ベースラインを設定し、四半期ごとに追跡する
無駄のないトラッキングの仕組みに必要なのは、たくさんのレポートツールを並べることより、安定した運用ルーティンです。担当者を決め、質問票をバージョン管理し、生データのエクスポートをダッシュボードの隣に保管します。
ベースライン調査をカレンダーに入れる
- 市場の定義を固定する。カテゴリを表す一文と、対象とする競合セットを記録します。測定を始める前に、SNS監査でアカウントとキャンペーンの一覧を整理しておくとよいでしょう。
- ベースライン調査を実施する。非助成と助成の質問をあわせて実施します。必要な精度から有効回答の数を決め、適格条件、サンプルサイズ、実施期間、募集方法を記録します。
- 繰り返しのウェーブを計画する。四半期ごと、または半年ごとに、同じ対象者条件と質問票で追跡します。特に成功したキャンペーンの後だけ調査するのではなく、比較可能な回収期間を維持します。
- 月次のシートを維持する。指名検索のインプレッションを前年の同じ月と比較して記録し、ダイレクトトラフィックとメンションも加えます。キャンペーンの実施日も、これらの推移の隣に残しておきます。
- キャンペーンの効果検証は早めに計画する。結果が出てからではなく、配信を購入する前に、ホールドアウトが実施可能かどうかを決めておきます。
投稿アナリティクスは、FoPostのプラットフォームで公開または追跡されたすべての投稿を対象としています。これらの記録は、レポートの配信とコンテンツパフォーマンスの部分に含めます。ブランド調査には、引き続き別の調査ツールが必要です。
今すぐ取り組むべきことは、今月中に調査の実施期間を日付つきで決め、今日のうちにチームのカレンダーへ入れることです。
FoPostは、AIエージェントをSNSに接続し、エージェントが投稿の企画、作成、予約を行えるようにします。公開前には、1つのカレンダー上で承認を行えます。チームはこのプラットフォームで投稿の運用を調整し、投稿アナリティクスを確認しながら、ブランド認知度は別のトラッカーで追跡できます。