Een stijging van 21% naar 24% bekendheid kan nog steeds niets bewijzen als de enquête een foutmarge van vijf procentpunten heeft, zoals toegelicht in de richtlijnen van SurveyMonkey over merkbekendheid. Meer bereikte mensen betekent niet per se dat meer mensen het merk onthouden. Zelfs een hogere enquêtescore heeft een onzekerheidscheck nodig voordat iemand het vooruitgang noemt.
Het praktische antwoord op de vraag hoe je merkbekendheid meet: volg spontane herinnering (unaided recall) en geholpen herkenning (aided recognition), combineer die met de vraag naar je merknaam in zoekmachines en gebruik een gerandomiseerde holdout als campagne-attributie ertoe doet. Voor creators, bureaus, developers en kleine teams die meerdere socialmedia-accounts beheren maakt dat het verschil tussen merken die onthouden worden en content die alleen verspreid is.
Inhoudsopgave
- Metrics voor merkbekendheid en wat ze je vertellen
- Zo zet je een enquête op die herinnering meet
- Gedragssignalen om naast enquêtes te volgen
- Zo bewijs je dat een campagne de bekendheid verhoogde
- Veelgemaakte fouten en hoe je ze oplost
- Stel je nulmeting vast en volg die elk kwartaal
Metrics voor merkbekendheid en wat ze je vertellen
Metrics voor merkbekendheid, formules en databronnen
| Metric | Wat het meet | Zo bereken je het | Databron |
|---|---|---|---|
| Spontane bekendheid | Merken die zonder hulp worden genoemd | Respondenten die het merk noemen gedeeld door gekwalificeerde respondenten, keer 100 | Enquête |
| Geholpen bekendheid | Merken die worden herkend uit een gerandomiseerde lijst | Respondenten die het merk herkennen gedeeld door gekwalificeerde respondenten, keer 100 | Enquête |
| Bekendheidsconversie | Hoeveel herkenning wordt omgezet in herinnering | Spontaan percentage gedeeld door geholpen percentage, keer 100 | Enquêteresultaten |
| Vertoningen van zoekopdrachten op merknaam | Vraag naar de naam van het merk in zoekmachines | Vertoningen voor zoekopdrachten met merktermen, vergeleken met dezelfde periode vorig jaar | Search Console |
| Brand lift | Geschatte door de campagne veroorzaakte verandering | Percentage van de blootgestelde groep min percentage van de controlegroep | Holdout-enquête |
| Vermeldingen en share of voice | Gespreksvolume ten opzichte van concurrenten | Tel merkvermeldingen; deel door het totaal aantal vermeldingen in de categorie voor het aandeel | Social-listeningtool |
Bereken geheugen voordat je activiteit interpreteert
De noemer is belangrijk. Gekwalificeerde respondenten zijn mensen binnen de gedefinieerde doelmarkt, niet iedereen die de vragenlijst heeft geopend. Het overzichtsartikel van TEM Journal over merkbekendheid maakt onderscheid tussen herkenning en herinnering en onderbouwt dat je bekendheid berekent als het aantal respondenten dat het merk noemt of herkent, gedeeld door gekwalificeerde respondenten, vermenigvuldigd met 100.
Houd top-of-mind awareness als aparte diagnostische meting aan: die registreert welk merk als eerste wordt genoemd. Een merk kan ergens in een spontaan antwoord voorkomen zonder de eerste optie te zijn die bij mensen opkomt.
Bekendheidsconversie vergelijkt spontaan ophalen uit het geheugen met bekendheid na een prompt. In het merkherinneringsvoorbeeld van SurveyMonkey is 24% spontane bekendheid gedeeld door 60% geholpen bekendheid, keer 100, gelijk aan 40% conversie. Dat is een diagnostische verhouding, geen bewijs dat specifieke respondenten een funnel hebben doorlopen.
Een grote kloof tussen herkenning en herinnering wijst erop dat blootstelling de naam vertrouwd heeft gemaakt zonder dat die makkelijk op te halen is. Dat wijst eerder op duidelijkere categorie-associaties dan op het inkopen van meer distributie.
Houd distributie in een aparte kolom van je dashboard
Bereik, vertoningen en aantallen volgers horen naast geheugenmetingen, niet in een samengestelde bekendheidsscore. De gids van Riff Analytics over hoe je merkbereik meet geeft nuttige context voor de kant van de blootstelling. Een apart KPI-raamwerk voor social media helpt om distributie, engagement en bedrijfsresultaten consistent te benoemen.
Regel voor een krap budget: Begin met spontane en geholpen bekendheid in dezelfde enquête en voeg daarna vertoningen van zoekopdrachten op merknaam toe. Een klein, herhaalbaar systeem is nuttiger dan een uitgebreid dashboard met wisselende definities.
Zo zet je een enquête op die herinnering meet
Een zuivere enquêteronde begint met een bevroren vragenlijst, niet met een campagnerapport. De gids van Sprig over brand tracking raadt aan spontane en geholpen bekendheid samen te meten en daarbij categorie, doelgroep, formulering en concurrentenset constant te houden.
Het proces moet van opzet tot rapportage herkenbaar blijven.
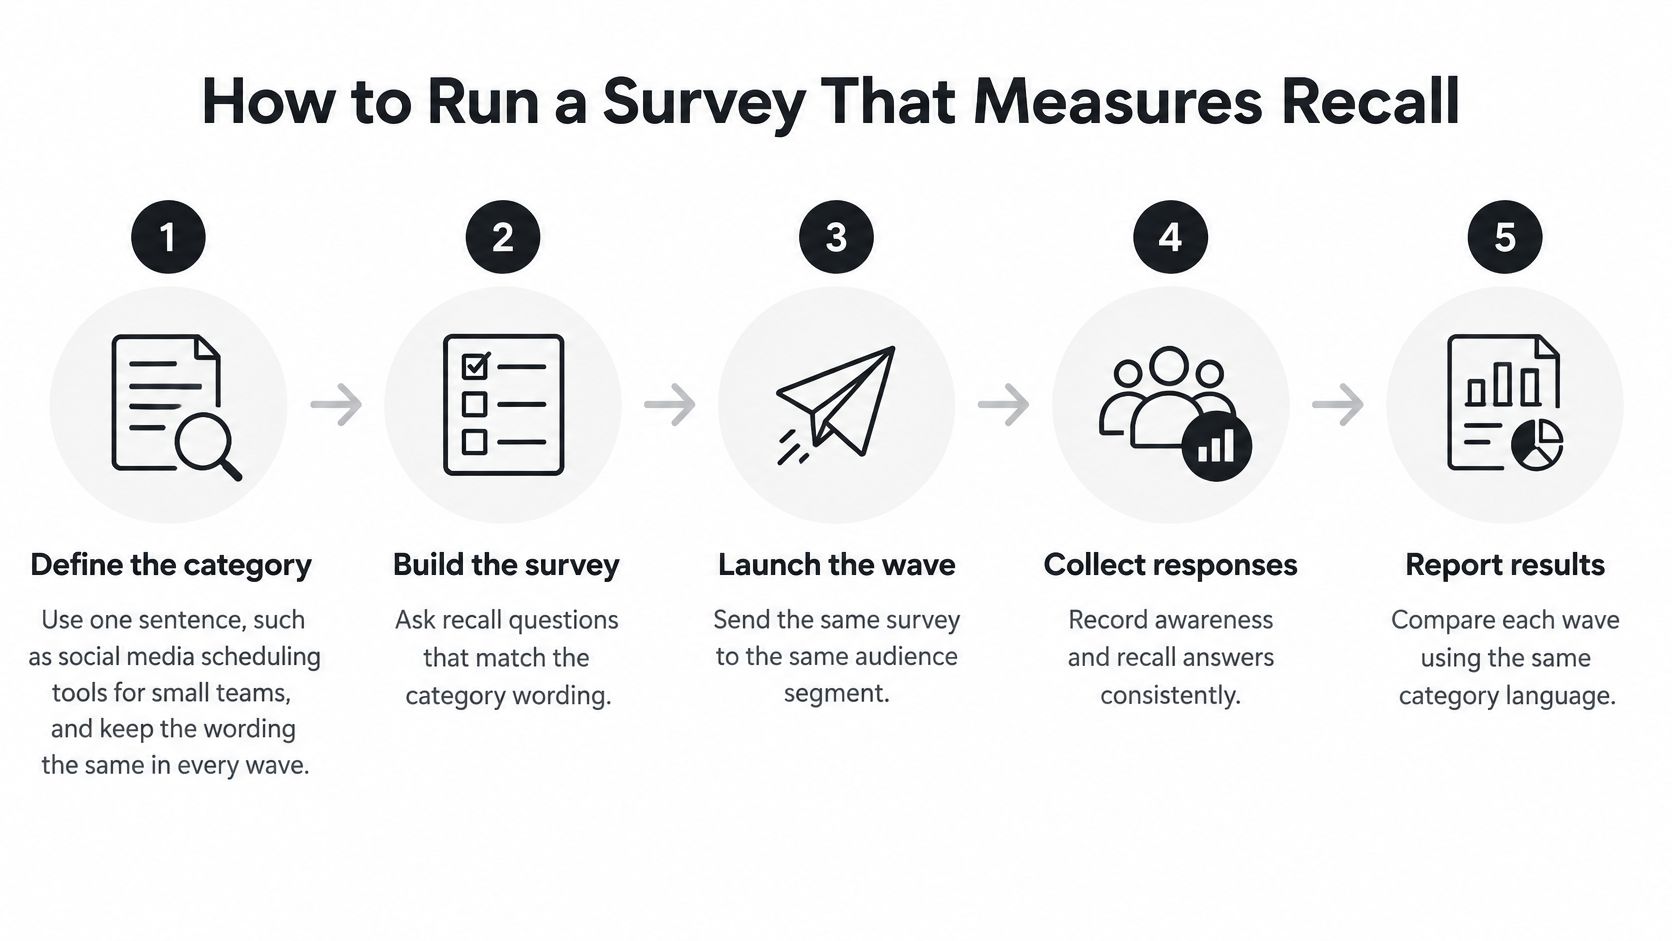
Bouw een herhaalbare enquêteronde
Definieer de categorie. Gebruik een zin als tools voor het inplannen van social media voor kleine teams. Als je die in de volgende ronde verbreedt tot marketingsoftware, verandert de taak die respondenten beantwoorden.
Bevries de lijst met concurrenten. Kies relevante alternatieven vóór het veldwerk en randomiseer de volgorde waarin ze worden getoond. Een trendy concurrent halverwege de dataverzameling toevoegen levert inconsistente vragenlijsten op.
Vraag eerst naar spontane herinnering. Vraag respondenten welke merken bij hen opkomen voor de categorie, zonder namen of logo's te tonen. Als je eerst de lijst laat zien, geef je geheugensteuntjes en vervuil je de spontane herinnering.
Meet daarna geholpen herkenning. Toon de gerandomiseerde lijst en vraag welke merken respondenten herkennen of kennen van naam. Vervang dit niet door een voorkeursvraag, want een merk leuk vinden is niet hetzelfde als het herkennen.
Screen de doelgroep. Werf mensen die in de categorie kopen of aankopen beïnvloeden, met elke keer dezelfde toelatingsregels. Alleen huidige volgers bevragen levert een andere populatie op dan de bereikbare markt.
Stel het veldwerkplan vast. Leg vóór de start het doel voor de gekwalificeerde steekproef, de verzamelperiode en de werfmethode vast. Stop de dataverzameling niet eerder omdat er een bemoedigend resultaat verschijnt.
Bereken en inspecteer. Rapporteer herinnering, herkenning en bekendheidsconversie op basis van de gekwalificeerde basis. Bewaar open antwoorden en stel codeerregels op voor spelfouten, productnamen en dubbelzinnige antwoorden.
Publiceer de methode bij het resultaat. Vermeld steekproefgrootte, doelmarkt, veldwerkdata, exacte formulering, onzekerheid, concurrenten en de vorige ronde. Een percentage zonder die context is lastig te controleren.
De voorbeeldvragen voor een enquête over merkbekendheid van Formbricks kunnen helpen bij het opstellen van de vragenlijst. Pas de formulering aan vóór de nulmeting en weersta daarna onnodige wijzigingen.
Controleer precisie en begrip vóór de lancering
Voor een hypothetische enkelvoudige aselecte steekproef van 400 gekwalificeerde respondenten geeft de standaardberekening voor proporties een 95%-marge van ongeveer 4.9 procentpunten rond 50%, of 4 punten rond 21%. Dit zijn berekende voorbeelden, geen belofte voor een opt-in panel; weging en werving kunnen de onzekerheid veranderen.
Een hypothetische stijging van 21% naar 24% bij die steekproefgrootte zou geen statistisch betrouwbare toename aantonen. Bovendien moet je voor significantie de onzekerheid van het verschil tussen de rondes controleren, en niet alleen of de verandering groter is dan de marge van één ronde.
Voeg na de geholpen herkenning een open vraag toe over wat het merk aanbiedt en voor wie. Codeer juiste, onjuiste en onduidelijke associaties apart, zodat naamsbekendheid geen positioneringsprobleem verbergt.
Gedragssignalen om naast enquêtes te volgen
Gedragssignalen laten zien welke acties mensen rond het merk ondernemen. Ze vervangen geen directe test van het geheugen, maar helpen je bepalen welke veranderingen nader onderzoek verdienen.
Een bruikbaar dashboard houdt de definitie van elk signaal zichtbaar.
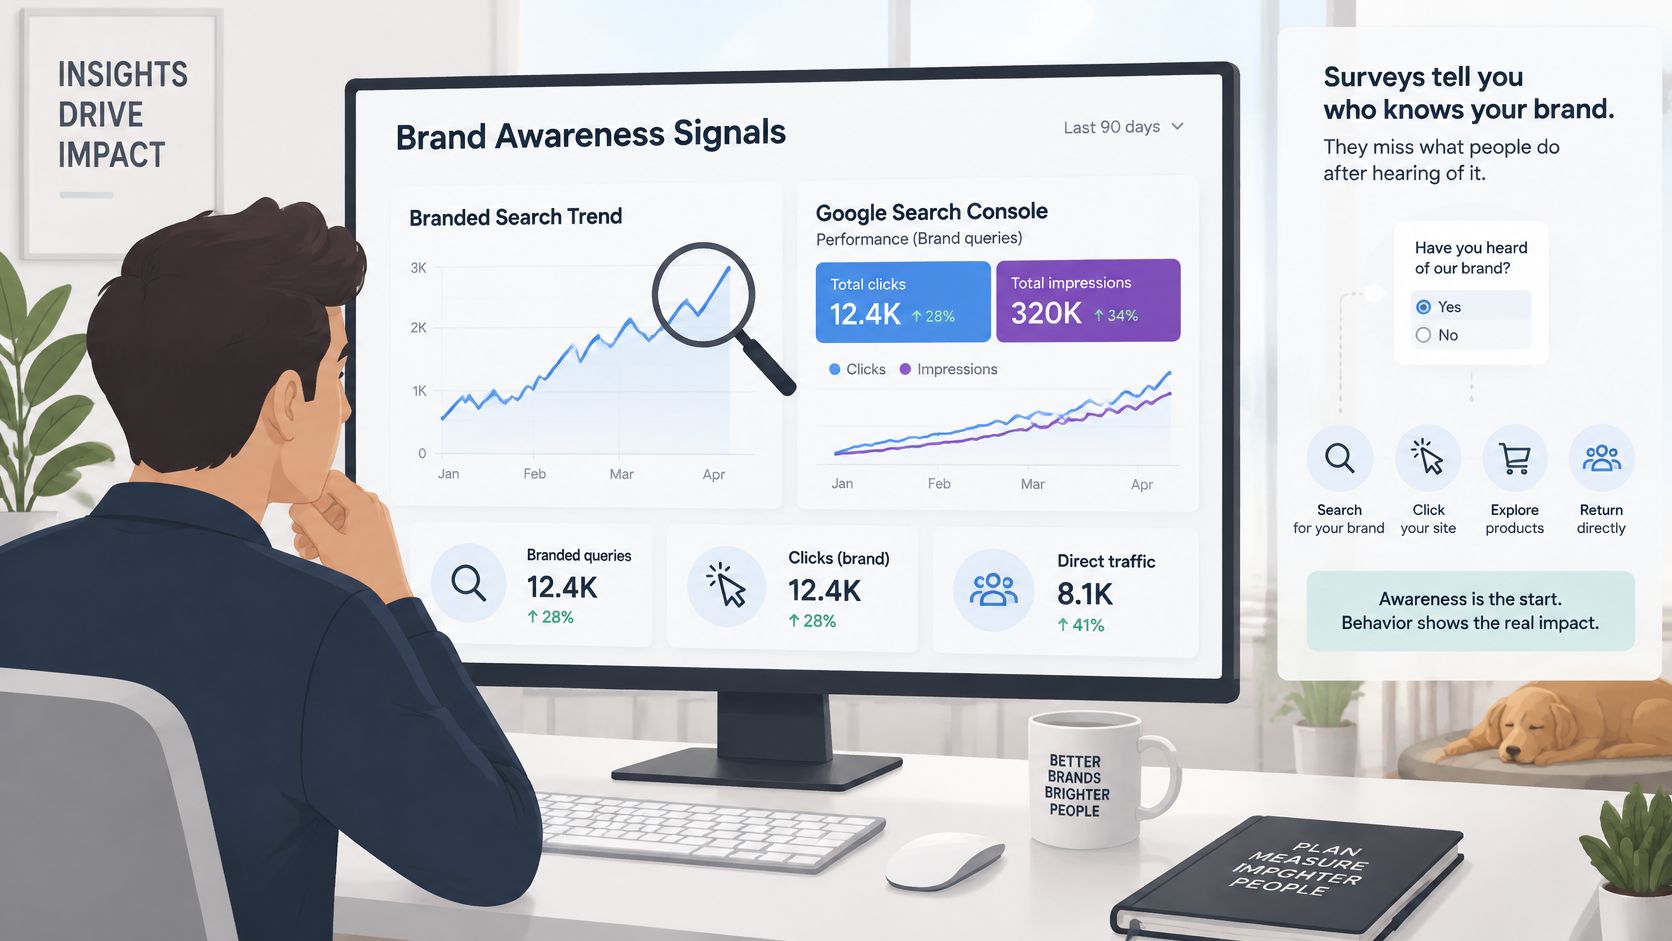
Scheid zoekvraag van websitebezoeken
Filter in Google Search Console het prestatierapport op de merknaam, productnamen en veelvoorkomende spelfouten. De richtlijnen van Search Engine Land over zoekopdrachten op merknaam raden aan om de afgelopen drie maanden te vergelijken met dezelfde periode het jaar ervoor, om seizoensinvloeden te beperken.
Vertoningen registreren hoe vaak je verschijnt in zoekresultaten op merknaam. Klikken hangen ook af van rankings, snippets, concurrerende resultaten en antwoorden waarvoor geen bezoek nodig is. Splits de resultaten waar mogelijk uit naar land, apparaat en zoekgroep.
Gedragssignalen: wat ze laten zien en hoe je ze controleert
| Signaal | Wat het kan laten zien | Wat het niet kan bewijzen | Controleer dit voordat je een verandering toeschrijft |
|---|---|---|---|
| Vertoningen van zoekopdrachten op merknaam | Vraag naar de naam in Google-resultaten | Nieuwe mensen of een campagne als oorzaak | Vergelijk gelijkwaardige seizoensperioden en combineer met een enquêteronde |
| Direct verkeer | Bezoeken zonder verwijzende bron | Nieuwe bekendheid, omdat herhaalbezoeken, bladwijzers en ingetypte URL's meetellen | Zet het af tegen enquêterondes, nooit op zichzelf |
| Aantal vermeldingen en share of voice | Gesprek over het merk ten opzichte van concurrenten | Uniek publieksbereik of onthouden blootstelling | Deel merkvermeldingen door het totaal aantal vermeldingen in de categorie, met consistente maandelijkse dekking |
| Vermeldingspercentage in AI-assistenten | Hoe vaak assistenten het merk noemen bij vaste prompts | Geheugen of herinnering bij mensen | Elke ronde dezelfde prompts, assistenten en instellingen |
Elk netwerk biedt een iets andere set metrics, en het FoPost-dashboard laat zien wat elk netwerk rapporteert. Vergelijk het aantal volgers op het ene netwerk niet met het bereik op een ander; een consistente workflow voor social media-analytics moet die labels behouden.
De bijbehorende video biedt een andere vorm om de meting van bekendheid door te nemen.
Audit AI-vindbaarheid zonder het herinnering te noemen
Stel een werkset van 20 tot 30 koopvragen samen, bedoeld als praktisch testontwerp en niet als gevalideerde steekproefgrootte. Neem vragen op over planning voor meerdere netwerken, door agents aangestuurd posten, publiceren via API en analytics.
Volg de richtlijnen van HubSpot over AI-zichtbaarheid en registreer verschijningen van het merk, juistheid van de beschrijving, vervanging door concurrenten en geciteerde bronnen. Bereken het vermeldingspercentage als antwoorden waarin het merk voorkomt gedeeld door geanalyseerde antwoorden, vermenigvuldigd met 100, en leg de versie van de assistent, locatie, taal en datum vast.
Een assistent die het verkeerde gebruiksdoel beschrijft is geen zichtbaarheidswinst, ook niet als het merk prominent voorkomt.
Stel dat de vertoningen op merknaam stijgen na een podcastcampagne. Controleer de volgende herinneringsronde voordat je de podcast het krediet geeft, en pas dezelfde discipline toe op een toename van AI-vermeldingen.
Zo bewijs je dat een campagne de bekendheid verhoogde
Een vergelijking van voor en na kan aantonen dat de bekendheid veranderde. Ze kan op zichzelf niet aantonen dat de campagne de verandering veroorzaakte. Activiteiten van concurrenten, publiciteit en andere marketing kunnen in dezelfde periode hebben plaatsgevonden.
Een gerandomiseerde holdout-studie biedt een sterker tegenfeitelijk scenario: wat zou er gebeurd zijn bij vergelijkbare in aanmerking komende mensen zonder de campagne?
Het ontwerp begint voordat er advertenties draaien.
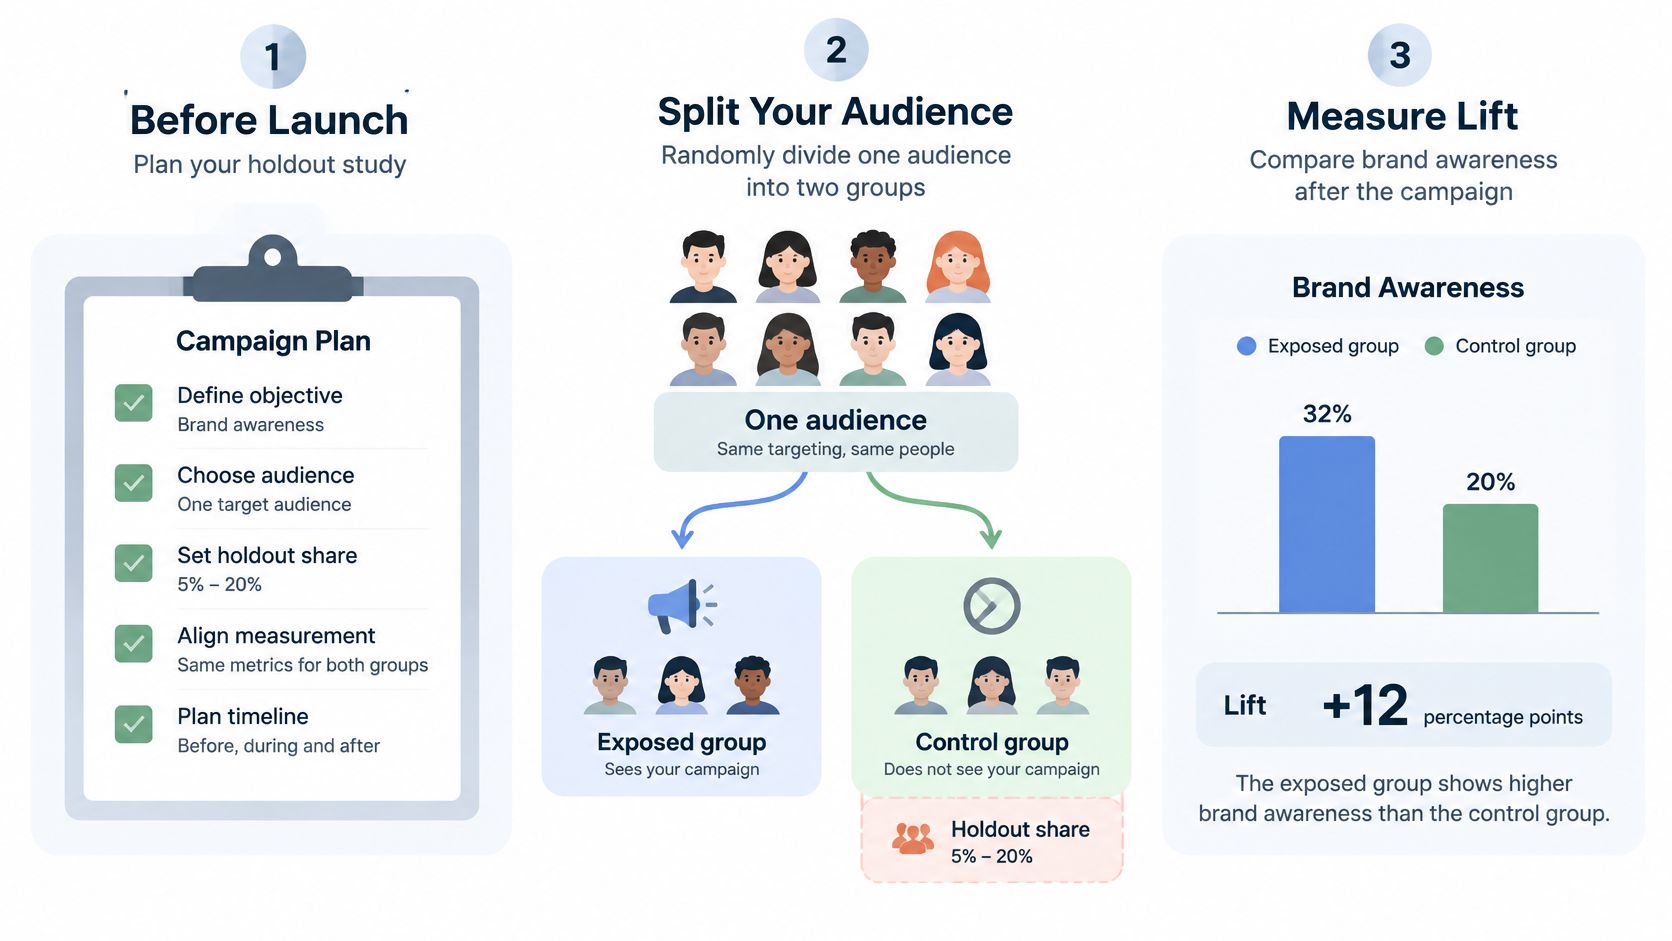
Bepaal de vergelijking vóór de lancering
- Randomiseer in aanmerking komende mensen. Wijs een blootgestelde groep toe die de campagne kan zien en een controlegroep die haar niet ziet. De gids van Sprig over advertentie-effectiviteit noemt 5% tot 20% een veelgebruikte omvang voor de controlegroep, en merkt op dat de benodigde steekproefgrootte afhangt van de kleinste detecteerbare lift.
- Zet de holdout vast. Leg de verdeling vast vóór de lancering. Mensen na het zien van de resultaten tussen groepen verplaatsen verzwakt de vergelijking.
- Houd de meting identiek. Bevraag beide groepen in hetzelfde tijdvak, met spontane vragen vóór de gerandomiseerde geholpen lijst. Een andere formulering zorgt voor een meetverschil bovenop het verschil in blootstelling.
- Check eerst de haalbaarheid. Schat de steekproef die nodig is voor het kleinste commercieel zinvolle effect. Een piepkleine controlegroep kan een anders verstandige test onbeslist maken.
Als het blokkeren van campagnelevering een vervangende plaatsing vereist, gebruik dan een niet-gerelateerde placeholder voor de controlegroep. Voeg een vraag over advertentieherinnering toe om het geheugen van de creatie zelf te beoordelen, zonder dat antwoord te behandelen als vervanging van de gerandomiseerde vergelijking.
Bereken absolute en relatieve lift
Neem een hypothetisch resultaat:
| Maatstaf | Uitgewerkt voorbeeld |
|---|---|
| Geholpen bekendheid blootgestelde groep | 30% |
| Geholpen bekendheid controlegroep | 24% |
| Absolute lift | 30% min 24% = 6 procentpunten |
| Relatieve lift | 6 gedeeld door 24, keer 100 = 25% |
Dit zijn illustratieve invoerwaarden, geen campagneresultaten. Procentpunten en procentuele lift zijn niet uitwisselbaar: het eerste drukt het verschil tussen scores uit, het tweede schaalt dat verschil ten opzichte van het resultaat van de controlegroep.
Een geloofwaardig rapport bevat de nulmeting als die is verzameld, de resultaten van blootgestelde en controlegroep, absolute lift, relatieve lift, steekproefgroottes per groep, veldwerkdata en onzekerheid. Als het resultaat te onnauwkeurig is, rapporteer het dan als onbeslist en niet als bewijs dat er geen effect is.
Voor campagneplanning kan de gids van MyMentions over merkbekendheid voor SaaS helpen om de geteste activiteiten te ordenen. Houd het strategiedocument gescheiden van het bewijs waarmee je causaliteit beoordeelt.
Veelgemaakte fouten en hoe je ze oplost
De meest voorkomende rapportagefout is een groot bereikcijfer presenteren als bekendheidsresultaat. De brand-liftgids van Webiano maakt onderscheid tussen blootstellingsmetrics en herinnering en herkenning, en raadt aan enquêtemethoden samen met campagneresultaten te rapporteren.
Een succes in distributie is misschien de moeite waard om te vieren. Het heeft alleen het juiste label nodig.
Veelgemaakte fouten bij het meten van bekendheid en hoe je ze oplost
| Fout | Waarom het misleidt | Oplossing |
|---|---|---|
| Bereik of vertoningen gerapporteerd als bekendheid | Bereik toont blootstelling, geen geheugen | Rapporteer bereik naast spontane herinnering en geholpen herkenning |
| Kleine verandering gerapporteerd als winst | Steekproefvariatie kan een ogenschijnlijke verbetering verklaren | Toets de onzekerheid in het verschil en vergelijk met eerdere rondes |
| Geholpen vraag als eerste gesteld | Een zichtbare lijst geeft respondenten een geheugensteun | Stel de spontane vraag eerst, elke ronde |
| Concurrentenlijst of formulering gewijzigd | Verschillende vragen verzwakken de vergelijkbaarheid | Bevries beide en vermeld elke gedwongen wijziging |
| Geen nulmeting vóór een campagne | Eén ronde kan geen beweging aantonen | Meet vóór de lancering en plan een holdout |
| Herkenning behandeld als begrip | Vertrouwdheid kan samengaan met het verkeerde gebruiksdoel | Vraag wat het merk doet en voor wie |
Laat de conclusie aansluiten op het bewijs
De oplossingen in de tabel pakken verschillende faalpunten aan. Opgeblazen bereik is een interpretatieprobleem; de volgorde van vragen is een instrumentprobleem; wisselende concurrenten zijn een vergelijkbaarheidsprobleem. Als je ze samenvoegt in één dashboardscore, worden de onderliggende fouten moeilijker te ontdekken.
Een ontbrekende nulmeting beperkt ook het verhaal. Een gerandomiseerde campagnevergelijking kan de lift nog steeds schatten zonder enquête vóór de campagne, maar een losse score na de campagne kan de historische richting van het merk niet beschrijven.
Onjuiste associaties verdienen hun eigen regel in het rapport. Voor een publicatieproduct voor developers zou herkenning als consumentenfotobewerker geen nuttige categoriebekendheid aantonen. Het team moet de boodschap en de verwijzingscontexten onderzoeken voordat het de promotie opvoert.
Rapportagestandaard: Benoem een resultaat als waargenomen, statistisch onderbouwd of onbeslist. Maak van een veelbelovende richting geen bewezen verbetering.
Controleer voordat je vooruitgang uitroept of het verschil groter is dan de verwachte steekproefvariatie, of werving en formulering vergelijkbaar zijn gebleven en of de beweging standhoudt ten opzichte van eerdere rondes en concurrenten. Een statistisch geloofwaardige stijging kan strategisch nog steeds zwak zijn als kopers het verkeerde onthouden.
Stel je nulmeting vast en volg die elk kwartaal
Een slank trackingprogramma heeft meer aan een stabiele routine dan aan een overvolle rapportagestack. Wijs een eigenaar aan, houd de vragenlijst van versies voorzien en bewaar de ruwe exports naast het dashboard.
Zet de nulmeting in de agenda
- Bevries de marktdefinitie. Leg de categoriezin en de genoemde concurrentenset vast. Een social media-audit kan de inventaris van accounts en campagnes ordenen voordat de meting begint.
- Voer de nulmeting uit. Draai spontane en geholpen vragen samen. Kies de gekwalificeerde steekproef op basis van de benodigde precisie en leg daarna toelatingscriteria, steekproefgrootte, veldwerkdata en werfmethode vast.
- Plan herhaalrondes. Gebruik kwartaal- of halfjaarlijkse tracking met dezelfde doelgroepcriteria en vragenlijst. Behoud vergelijkbare verzamelperiodes in plaats van alleen te bevragen na uitzonderlijk succesvolle campagnes.
- Onderhoud een maandelijks overzicht. Log vertoningen van zoekopdrachten op merknaam tegenover dezelfde maand vorig jaar, plus direct verkeer en vermeldingen. Houd campagnedata naast die trends.
- Plan campagne-attributie vroeg. Bepaal of een holdout haalbaar is voordat je distributie inkoopt, niet nadat de resultaten binnen zijn.
Postanalytics dekken elke post die via het FoPost-platform is gepubliceerd of gevolgd. Die gegevens horen thuis in het deel van het rapport over distributie en contentprestaties; voor merkenquêtes heb je nog steeds een aparte enquêtetool nodig.
De directe actie: kies deze maand een veldwerkperiode met data en zet die vandaag nog in de agenda van het team.
FoPost koppelt een AI-agent aan sociale netwerken, zodat de agent posts kan plannen, schrijven en inplannen, met goedkeuring in één agenda vóór publicatie. Teams kunnen het platform gebruiken om het publiceren te coördineren en postanalytics te bekijken naast een aparte tracker voor merkbekendheid.